1
看很多例子
读大量句子,记住常见的词语搭配。
“今天天气真不错。”
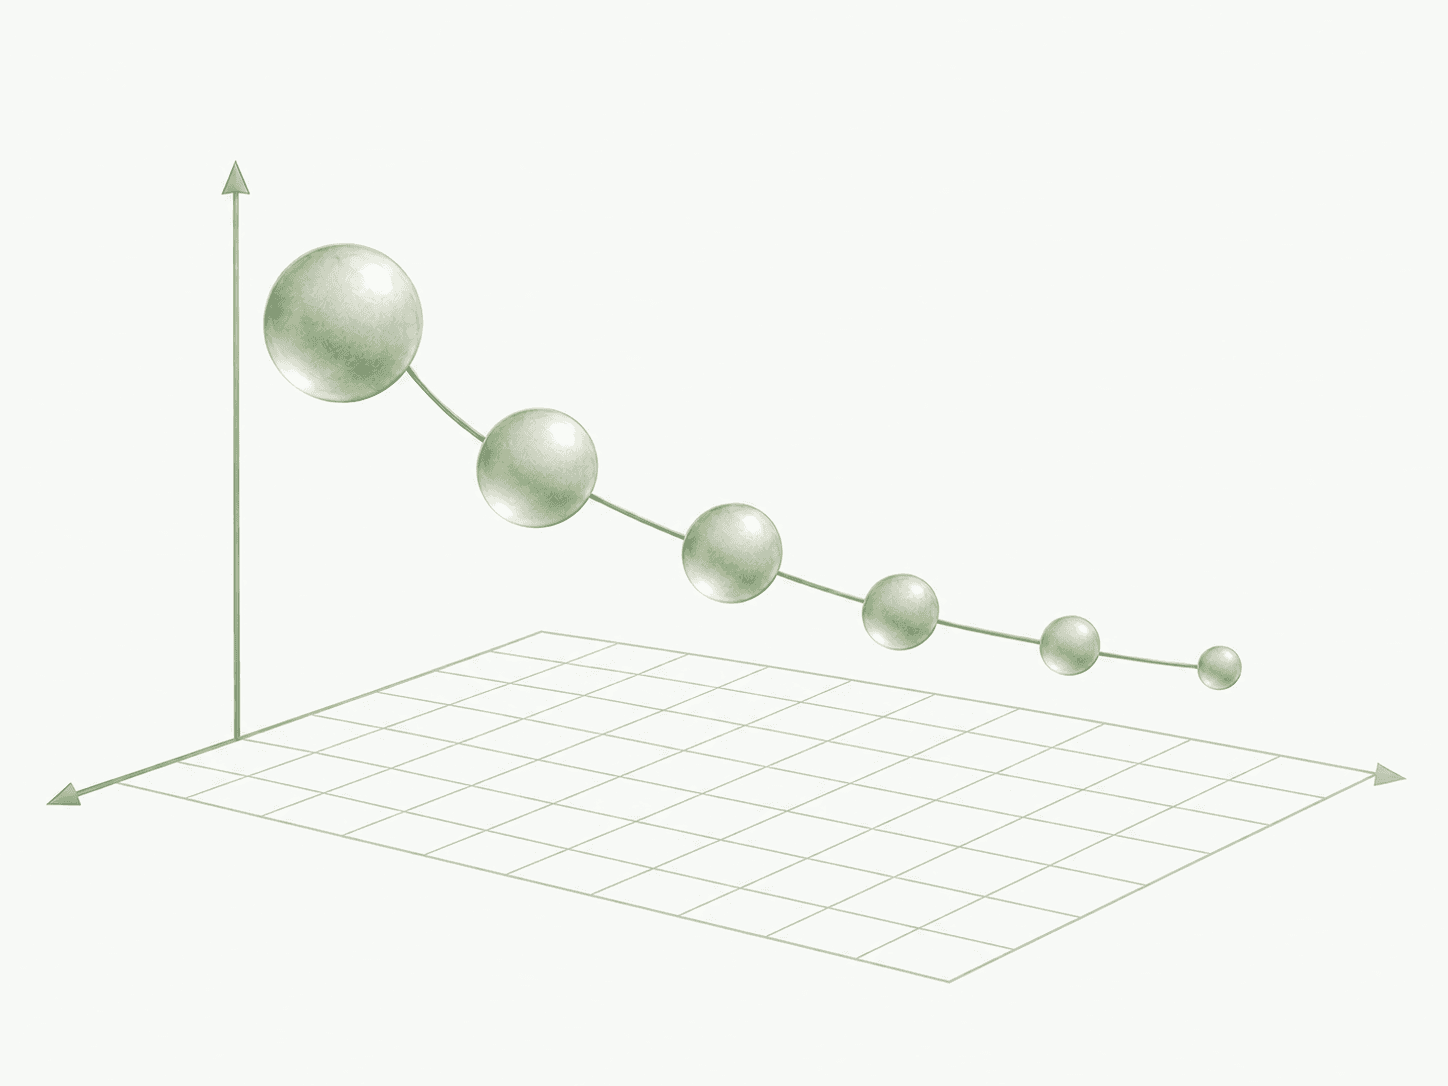
2020 年,Jared Kaplan、Sam McCandlish 等人发表了《Scaling Laws for Neural Language Models》。他们通过语言模型实验,研究测试损失如何随模型参数量、训练数据量和训练算力变化,发现在论文考察的范围内,这些关系近似遵循幂律。这项研究让规模扩展带来的效果更容易估计,也为后续研究如何分配模型、数据和算力提供了重要参考。
01 / 先看懂它在做什么
想象教一个小朋友玩“猜下一个词”的游戏。
读大量句子,记住常见的词语搭配。
“今天天气真不错。”
读得越多,越知道哪些词常接在一起。
“今天天气……”后面可能是什么?
根据学到的规律,给候选词分配概率。
“真”比“不”更可能接在后面。
论文研究的是:把模型做大、让它读更多内容,或者投入更多计算后,它猜错的程度会怎样变化?
02 / 动手实验
选一个变量,拖动滑块,观察对应的曲线。
下图按论文报告的幂律指数归一化绘制,用来理解趋势。算力曲线指最优分配时的计算效率前沿;这些曲线不是原始实验数据,也不能直接相加预测同一个模型。
网络里可学习的数字有多少
训练时读了多少文本
按论文研究的最优方式分配计算
横轴:规模增加的倍数 · 纵轴:相对测试损失
选择的变量增加到 100 倍 时,示意曲线上的相对损失约为 70%。基准点设为 100%。
你会看到
规模每增加相同的倍数,损失仍会下降;但想把损失再降低同样多,往往需要更大的规模投入。
这里的“损失”衡量模型预测下一个词时的不确定程度,越低越好。
03 / 一起扩展
模型、数据与算力彼此关联。单独增加其中一个,其他瓶颈不会自动消失。
模型有更多参数,却没有足够多的训练例子;继续增大模型,额外的收益会受数据限制。
给更大的模型足够的训练数据和算力,才能更充分地利用扩展带来的潜力。
04 / 资源分配
训练预算有限时,参数量与训练步数需要取舍。
这张图说明 2020 年论文的结论:在它研究的模型、数据与训练设置中,较大的模型即使训练较少步,也能更有效地利用固定计算预算。这里不使用原论文的数值坐标。
归一化机制示意 · 曲线不是论文原始实验数据
05 / 影响与边界
这篇论文让“扩大多少规模会得到怎样的测试损失”变得可估计。后来 Chinchilla 在新的设置下重新研究固定算力的分配,发现许多大模型训练时见过的数据偏少,提出模型参数与训练 token 数应更均衡地一起增长。
在其设置下,计算最优策略倾向更大的模型、较少训练步数。
在新的研究范围内,参数量和训练 token 数宜近似同步扩展。